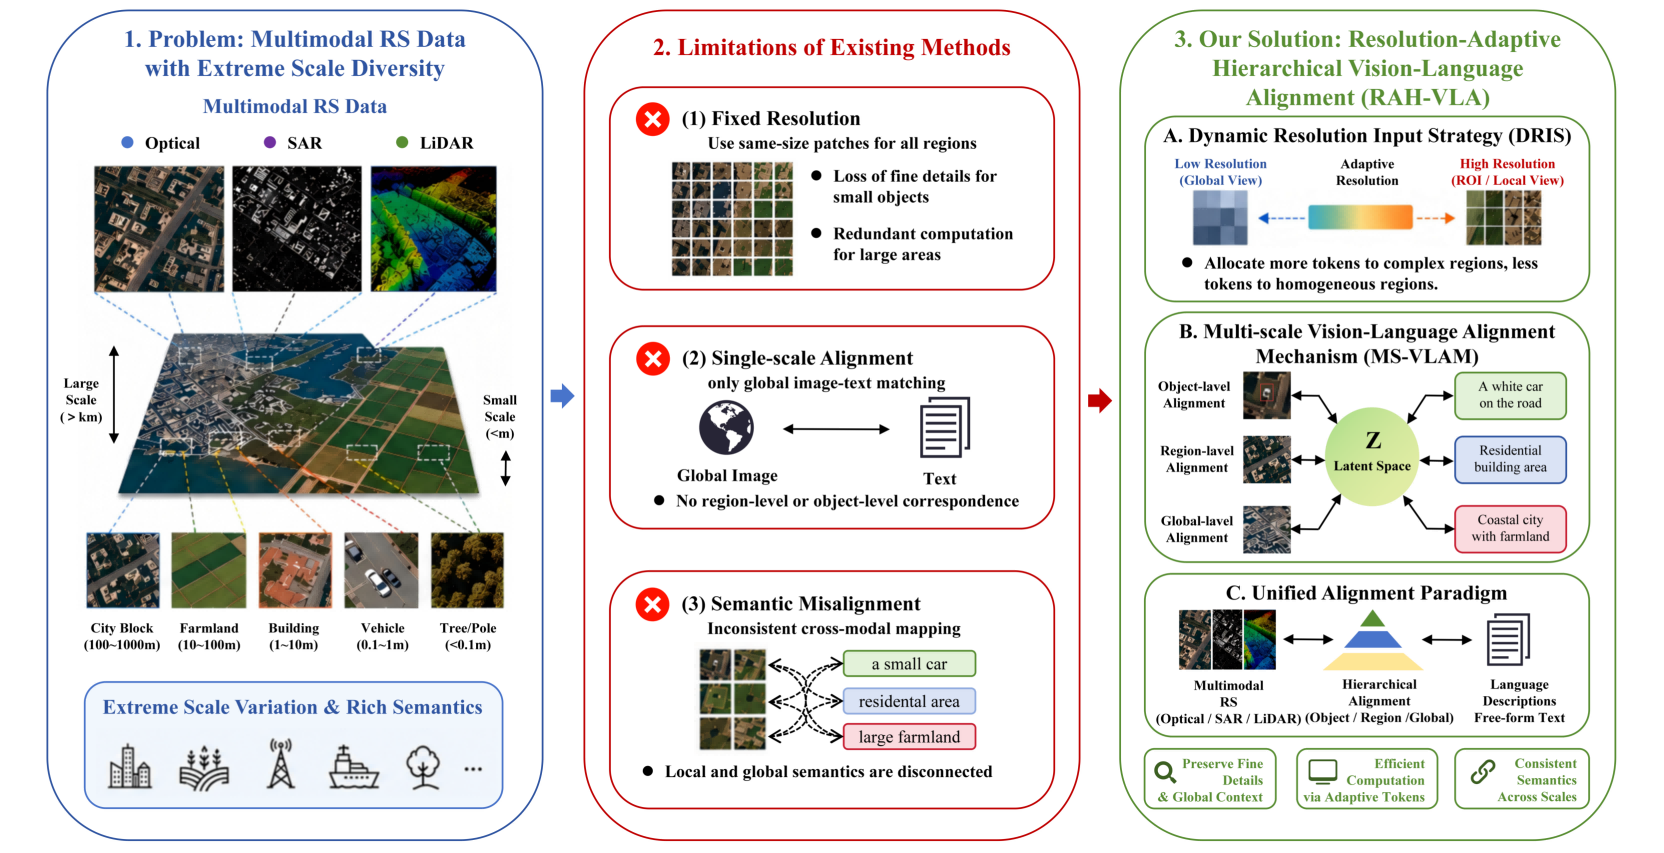
本项目面向复杂遥感场景下的精准语义理解需求,针对现有多模态视觉-语言模型在固定分辨率图像处理过程中难以兼顾全局场景信息与小目标细节,以及单一尺度视觉-语言对齐难以建立细粒度语义关联的问题,提出动态分辨率与多尺度视觉-语言对齐相结合的遥感图像理解框架 RAH-VLA。项目设计动态分辨率输入策略(DRIS),根据图像区域的显著性动态分配视觉计算资源,并构建多尺度视觉-语言对齐机制(MS-VLAM),实现目标级、区域级与全局级的层次化语义对齐。该方法在遥感图像描述、视觉定位、多模态推理及高光谱图像理解等任务中取得了良好的实验效果,为高效、精准且具有跨模态泛化能力的遥感视觉-语言模型提供了新的研究思路。
基于多模态大语言模型的遥感图像精准理解——动态分辨率与多尺度视觉-语言对齐研究
项目简介
详细介绍
本项目围绕多模态大语言模型在遥感图像理解中的关键技术问题展开研究,重点解决遥感场景尺度变化大、微小目标细节易丢失、视觉特征与文本语义对应关系不充分,以及模型计算开销较高等问题。
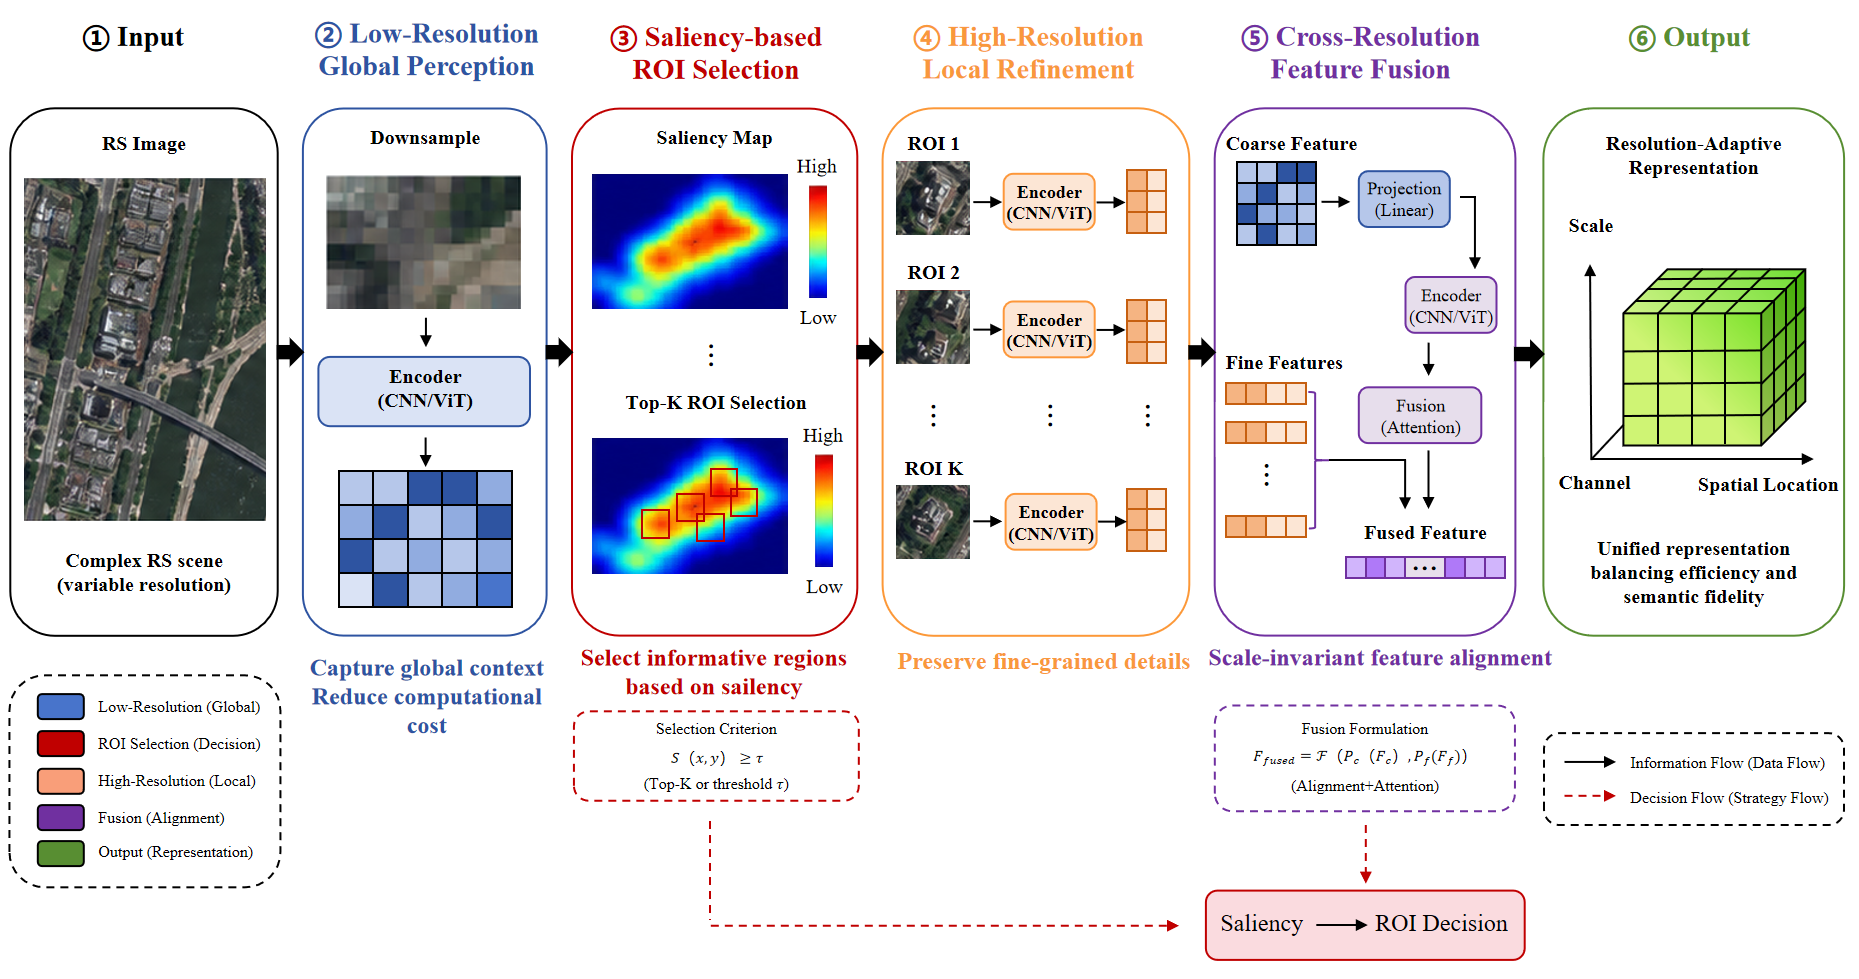
在动态分辨率视觉感知方面,项目提出动态分辨率输入策略(DRIS),采用由粗到细的处理流程:首先通过低分辨率分支获取全局场景信息并计算区域显著性,再筛选具有较高语义重要性的区域进行高分辨率细化,最后通过跨分辨率特征融合兼顾全局上下文与局部细节,减少冗余视觉计算。
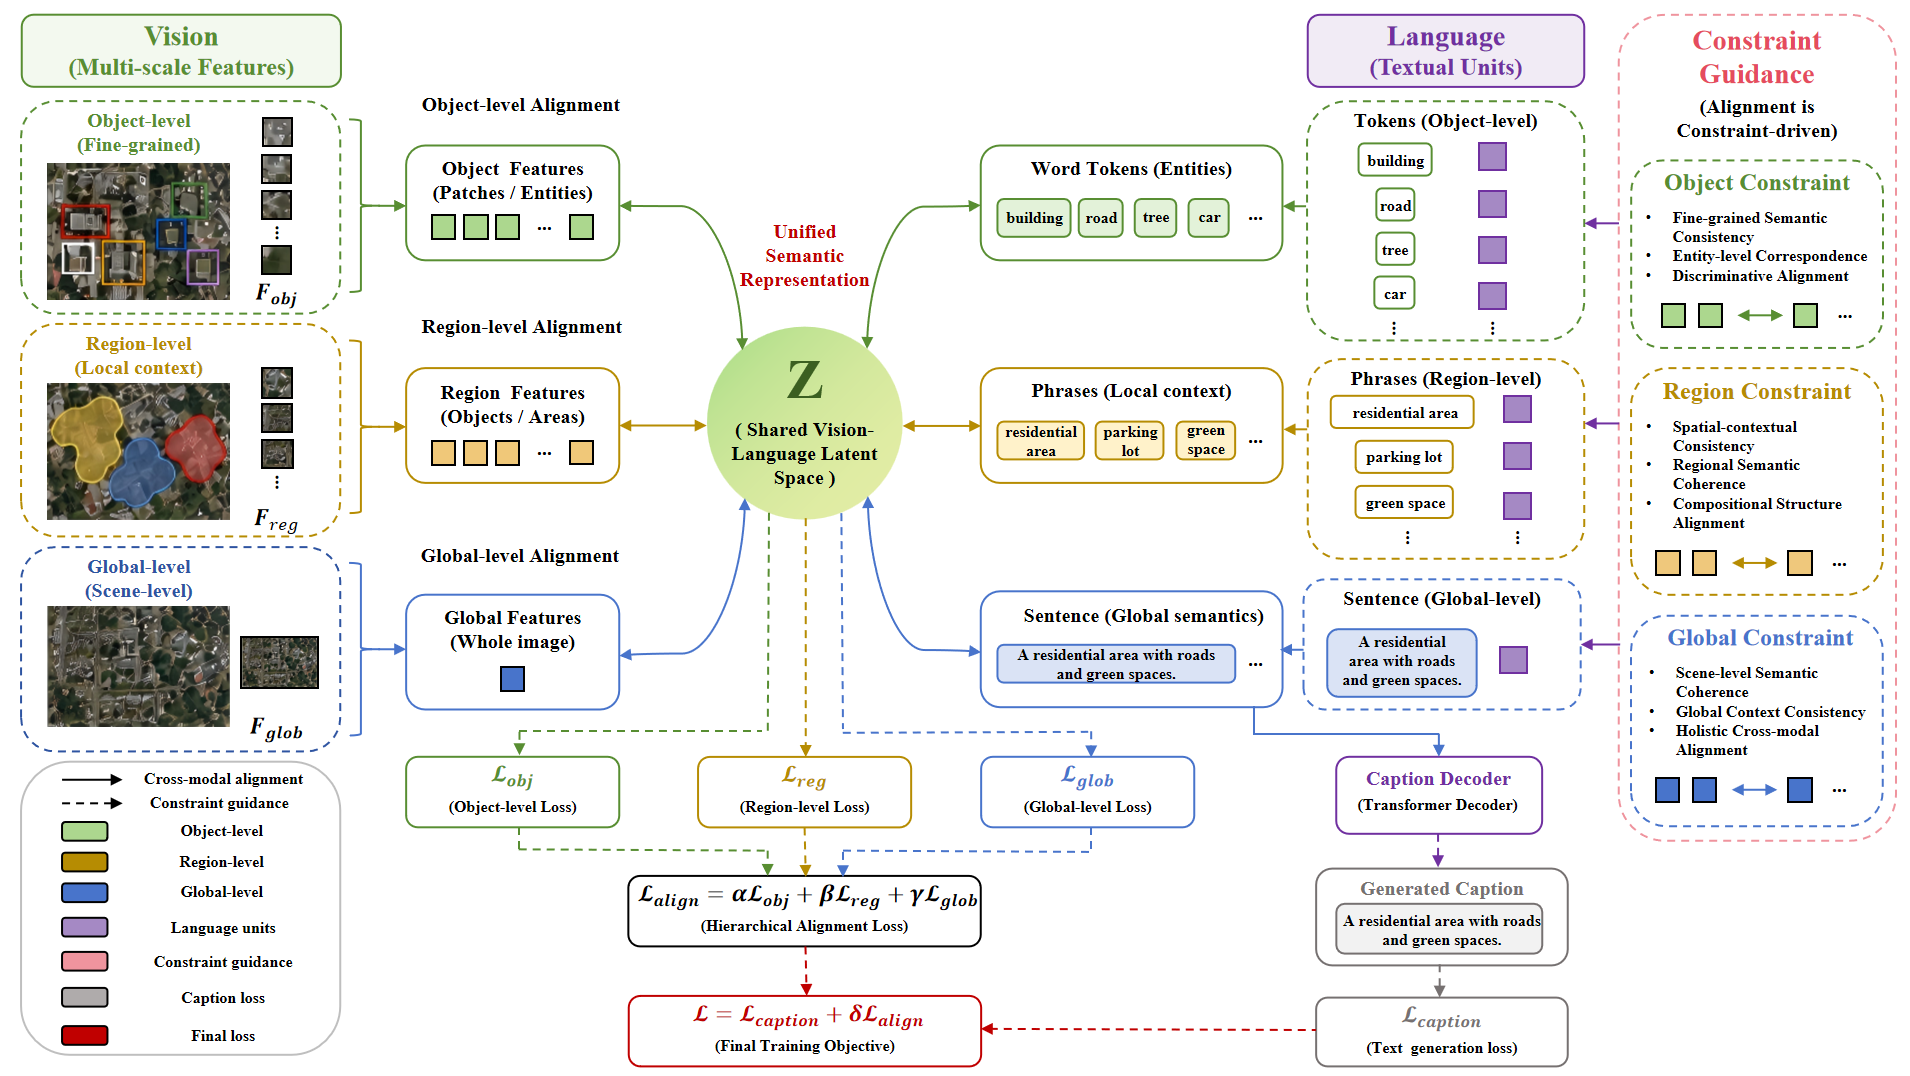
在多尺度视觉-语言语义对齐方面,项目提出多尺度视觉-语言对齐机制(MS-VLAM),将视觉与文本之间的语义交互划分为目标级、区域级和全局级三个层次。其中,目标级对齐关注建筑、车辆、船舶等具体实体;区域级对齐关注局部空间上下文及目标间关系;全局级对齐关注机场、港口、居民区等整体场景语义。通过联合优化层次化对齐目标与文本生成目标,增强模型对局部细节、空间关系和整体场景的协同理解能力。
在模型训练与实验验证方面,项目基于 GeoChat 架构开展研究,采用 CLIP ViT-L/14 作为视觉编码器、Vicuna-7B-v1.5 作为语言解码器,并结合 LoRA 等参数高效微调方法进行模型训练。通过 RSICD、NWPU-Captions、UCM-Captions、Sydney-Captions、DIOR-RSVG 及 HyperCap 等数据集,从图像描述、视觉定位、多模态推理和跨模态泛化等方面开展系统评估,并通过消融实验和计算效率分析验证各模块的有效性。
我的贡献
作为该研究的第一作者,我围绕遥感图像精准理解中的分辨率适应与跨模态语义对齐问题,主导开展研究方案设计、核心方法构建、实验验证与论文撰写工作。针对现有多模态视觉-语言模型在固定分辨率处理下难以兼顾全局场景信息与局部细节、单尺度对齐难以充分建立视觉内容与文本语义关联的问题,设计并构建 RAH-VLA 整体框架,提出动态分辨率输入策略(DRIS)与多尺度视觉-语言对齐机制(MS-VLAM),实现关键视觉区域的自适应感知以及目标级、区域级和全局级的层次化语义对齐。在此基础上,开展模型实现与训练优化,设计多数据集对比实验、模块消融实验及计算效率分析,系统验证所提方法在遥感图像描述、视觉定位、多模态推理及跨成像模态泛化等任务中的有效性。
成果亮点
本项目提出了融合动态分辨率视觉感知与多尺度视觉-语言语义对齐的遥感图像理解框架,在提升模型语义理解能力的同时兼顾计算效率。在计算效率方面,相较于基础模型,所提方法将浮点运算量降低 38.4%、推理延迟降低 35.6%、显存占用降低 25.3%;在视觉定位任务中,模型于 DIOR-RSVG 数据集上取得 40.27 的 Accuracy@0.5,较基线模型的 33.15 提升 7.12 个百分点。在跨模态泛化方面,模型在 HyperCap 高光谱图像描述基准上的 CIDEr 指标整体提升 149.8%,验证了所提方法向不同成像模态迁移的潜力。相关研究成果以第一作者发表于 IEEE Transactions on Geoscience and Remote Sensing(IEEE TGRS,2026),为多模态大语言模型在复杂遥感场景中的高效、精准理解提供了具有实践价值的技术方案。
项目图集